项目快过(图像配准 | AsPanFormer) Detector-Free Image Matching with Adaptive Span Transformer

论文地址:https://arxiv.org/abs/2208.14201
项目地址:https://github.com/apple/ml-aspanformer
csdn论文简读:https://blog.csdn.net/qq_34426949/article/details/133861450
在图像之间生成鲁棒和可靠的对应关系是各种应用程序的基本任务。为了在全局和局部粒度上捕获上下文,我们提出了一种基于探测器的匹配器,它基于变换器,采用了一种新的注意操作,能够以自适应的方式调整注意广度。为了实现这一目标,首先,1、在每个交叉注意阶段回归流程图,以定位搜索区域的中心。接下来,2、在中心周围生成一个采样网格,其大小不是根据经验配置为固定的,而是根据流图估计的像素不确定性自适应计算。最后,3、在衍生区域内的两个图像上计算注意力,称为注意力广度。通过这些方法,我们不仅能够保持长期依赖,而且还能够在高相关性像素之间实现细粒度的注意,从而补偿匹配任务中的基本局部性和分段平滑性。在广泛的评估基准上的最先进的精度验证了我们的方法的强匹配能力。
1、算法信息
1.1 网络结构
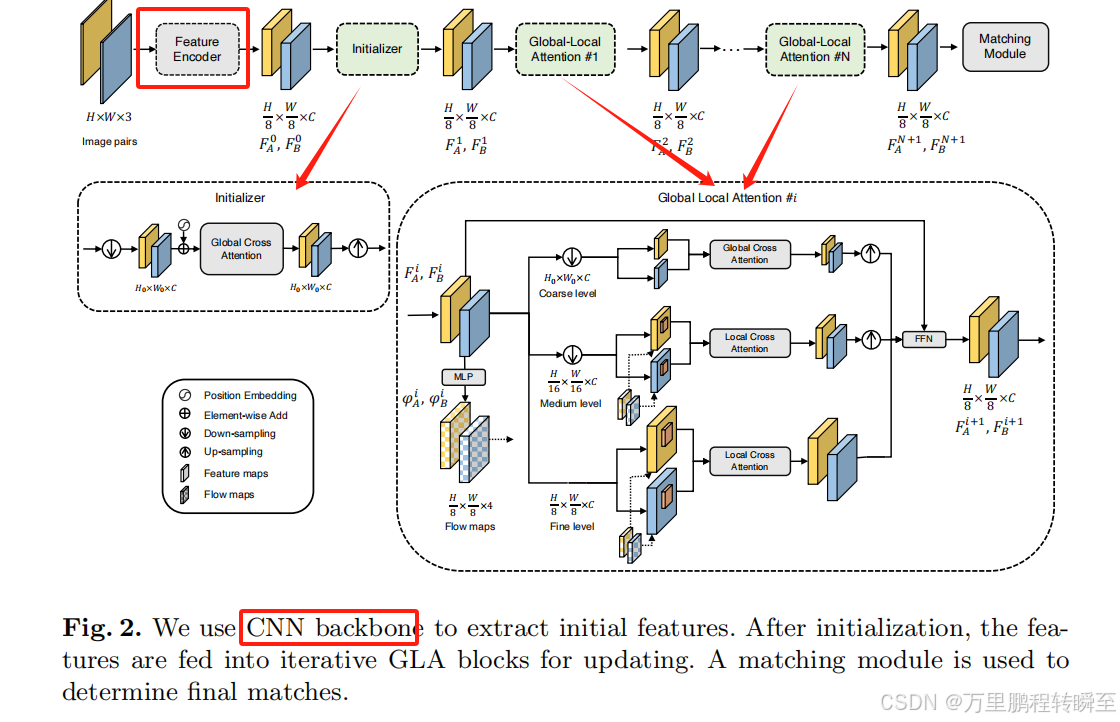
图2中概述了模型结构。以一个图像对IA,IB作为输入,网络在图像之间产生可靠的对应关系。匹配过程从一个基于cnn的编码器开始,分别提取两幅图像的初始特征F 0 A、F0 B。初始化后,将这些特征转换为F 1 A、F1 B,并输入提出的自适应跨transformer(ASpanfrorr)模块进行更新,该模块由具有分层结构的迭代全局局部注意(GLA)块组成。对于每个GLA块,我们回归了描述对应坐标(流)及其不确定性的辅助流图φA、φB。我们没有采用这些流图作为我们的对应输出,而是使用它们来指导局部交叉注意,根据匹配的不确定性实现自适应的局部注意跨度。在N个GLA块之后,使用更新后的特征F(A N+1)、F(B N+1)来构建粗级匹配,并将进一步细化为最终的对应关系。
1.2 特征提取
网络的第一部分使用卷积神经网络(CNN)为每张图像提取1/8的降采样初始特征FA,FB∈R (H/8×W/8)。CNN表现出了很强的捕获局部上下文并生成高级特征的能力,这些特征可以直接用于执行最近邻匹配。然而,由于这些特征是为每个图像独立处理的,因此错过了关键的交叉视图上下文。为了丰富长范围和交叉视图背景下的特征,将初始特征进一步输入到我们提出的transformer模块中进行更新。
1.3 transformer模块
transformer模块从一个快速初始化块开始,该块执行(1)位置编码和(2)双视图上下文初始化。位置编码正如在变压器网络[13,30,14]中验证的那样,位置编码对于维护扁平标记的空间信息至关重要。按照LoFTR [13]中相同的公式,使用不同频率的二维正弦信号对位置信息进行编码,并添加到初始特征中。特别地,当测试分辨率与训练分辨率不同时,我们应用归一化。
在每个局部注意阶段,网络需要回归一个辅助流程图作为指导,这需要交叉视图上下文。为此,我们将位置嵌入的特征传递给一个轻量级的交叉注意块。更具体地说,这些特征被降采样到低分辨率的h0、w0,并使用两个全局交叉注意块进行特征处理。初始化后,将特征上采样到原始输入分辨率,记为F1 A、F1 B,并发送到迭代的全局-局部匹配
1.4 loss组成
三个部分来制定最终的损失,(1)粗匹配损失Lc,(2)精细水平损失Lf和(3)流估计损失Lflow

对于粗水平损失Lc,地面真实匹配是通过使用数据集中的深度和相机姿态重新投影来确定的。具有交叉熵损失的dual-softmax最大分数矩阵S
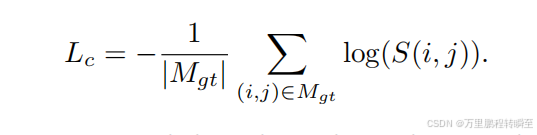
精细水平损失通过每个细化坐标Mf(i,j)和地面真实重投影坐标之间的l2距离直接监督,并通过坐标方差进一步归一化.
对于流估计监督,我们最小化每个估计分布的对数似然。形式上,给定从每一层和地面的流量估计Φ,Lf low被定义为:
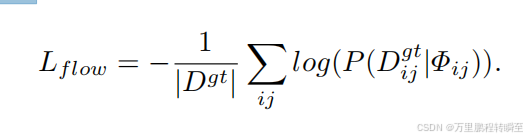
2、相关知识
模型使用了两个流行的数据集,ScanNet [47]和MegaDepth [48],来分别演示方法在室内场景和室外场景中的匹配能力。
2.1 相关数据集
Indoor two-view matching dataset
ScanNet数据集[47]由1613个序列组成,每个序列包含RGB图像,显示大的视图变化和重复或无纹理的模式,与地面真实深度地图和相机姿态相关联。为了公平比较,我们遵循与SuperGlue [30]和LoFTR [13]相同的训练和测试协议,其中分别采样230M和1.5K图像对进行训练和测试。与LoFTR一致,我们将所有测试图像的大小调整为480×640。
Outdoor two-view matching dataset
MegaDepth [48]由196个互联网图像进行的三维重建组成,其相机姿态和深度地图最初从COLMAP [1]计算,然后细化为地面真相。我们对1.5k个测试对进行了两个视图姿态估计。所有测试图像都调整大小,使其最长尺寸为1152。
2.2 评价指标
通过从产生的对应关系中求解基本矩阵来恢复双视点姿态信息,而姿态精度在多个误差阈值(5◦、10◦和20◦)下由AUC测量。只有当一个姿态的角度旋转误差和平移误差都低于一定的阈值时,它才被认为是准确的
3、指标信息
3.1 目标数据集信息
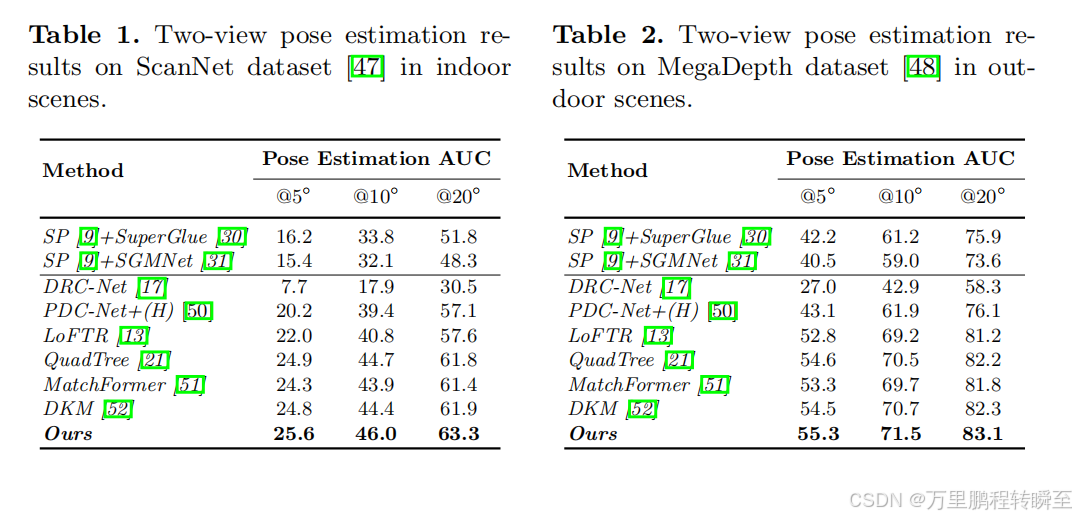
在室内与室外数据中,可以看到aspanformer模型都保持了领先的效果
在InLoc数据集上,如表3所示,与多个比较方法相比,AsPanFormer方法获得了总体上最好的结果。在Aachen V1.1上,如表4所示,AsPanFormer优于除SuperGlue之外的所有其他方法。我们将此部分归因于我们只使用粗匹配来进行数据库重建(见附录A.4.)造成定位错误,危害姿态估计。一般来说,我们的方法在实际的pipeline中可以很好地推广。

3.2 流估计流程
下图是算法提取的对应关系估计图,也就是flow图

下图是流(匹区域个迭代估计过程)

基于流估计,可以滤除错误匹配的点

3.3 点匹配效果
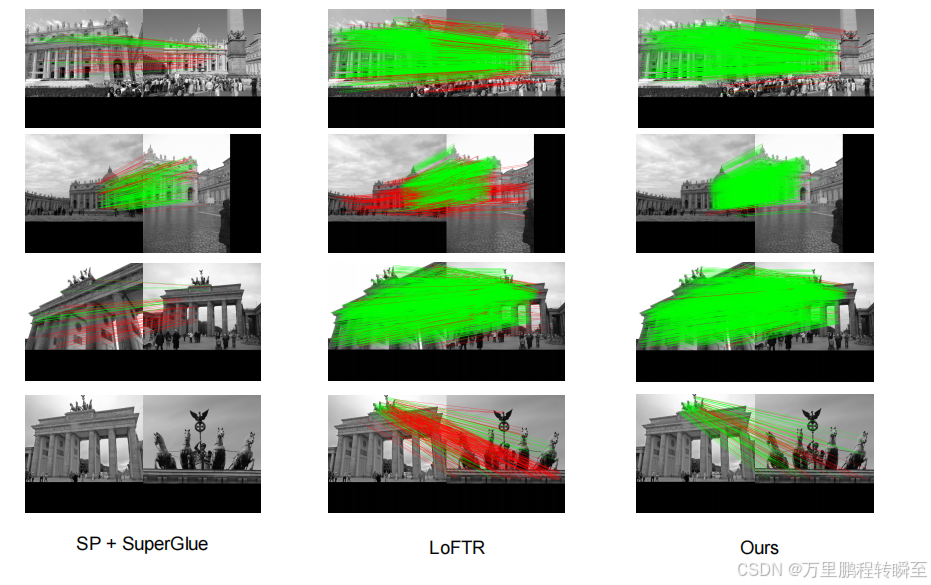
下图是在室内数据集中,不同方法间提取的点对关系,可以看到AsPanFormer提取的点数更密集

下图是在室外数据集中,不同方法间提取的点对关系,可以看到AsPanFormer提取的点数更密集;而SP+SG方案却还存在一定遗漏。
3.4 算法速度
通过论文数据来看,AsPanFormer比LoFTR略多耗时20ms,但在320x320的输入下,3060显卡下,预计耗时差异不超过5ms。

4、使用项目
4.1 下载项目
打开https://github.com/apple/ml-aspanformer ,下载项目并解压

下载预训练模型:https://drive.google.com/file/d/1eavM9dTkw9nbc-JqlVVfGPU5UvTTfc6k/view ,并解压放到weights目录下

4.2 代码分析
打开test.py,发现运行项目需要配置data-cfg,故而只对模型相关代码进行分析。可以看到相关代码应该是在PL_ASpanFormer类中。

进入PL_ASpanFormer类,可以发现进行匹配的模型应该是ASpanFormer类。

通过对ASpanFormer类代码进行分析,观察其forward函数,发现没有返回值,只标注了Update,也就是说传入dict,结果会更新到dict的key中。

再次回归到PL_ASpanFormer类中,观察test_step函数,发现关键的key值’mkpts0_f’, ‘mkpts1_f’, ‘mconf’, ‘epi_errs’

4.3 模型剥离
通过对test.py代码关键部分进行溯源,基本理通了模型,与其使用方式。这样可以直接剥离出模型,自己写一套顺手使用的部署代码。
修改一: 在parser中添加默认配置,具体修改如下,将原来的data_cfg_path与main_cfg_path,修改为–data_cfg_path与–main_cfg_path,并设置了对应的配置文件。同时为ckpt_path赋值为真实的模型路径。
def parse_args():
    # init a costum parser which will be added into pl.Trainer parser
    # check documentation: https://pytorch-lightning.readthedocs.io/en/latest/common/trainer.html#trainer-flags
    parser = argparse.ArgumentParser(formatter_class=argparse.ArgumentDefaultsHelpFormatter)
    parser.add_argument(
        '--data_cfg_path', type=str, default=r"configs\data\scannet_test_1500.py", help='data config path')
    parser.add_argument(
        '--main_cfg_path', type=str, default=r"configs\aspan\indoor\aspan_test.py", help='main config path')
    parser.add_argument(
        '--ckpt_path', type=str, default="weights/indoor.ckpt", help='path to the checkpoint')
修改二:保存模型,并终止后续代码。具体修改为,在test.py第60行添加模型保存,并退出运行。具体操作为:

代码运行后会在项目根目录下生成一个ASpanFormer.pt,具体如下图所示

4.4 使用模型
代码依赖的imgutils类,打开https://blog.csdn.net/a486259/article/details/124824892 将章节1的代码保存为imgutils.py即可
将以下代码保存为项目根目录下的run.py
import torch
from imgutils import *
import time
# Initialize LoFTR
matcher = torch.load("ASpanFormer.pt")
matcher = matcher.eval().cuda()

p1=r'C:\Users\hpg\Pictures\t1.jpg'
p2=r'C:\Users\hpg\Pictures\t2.jpg'
t1,im1=read_img_as_tensor_gray(p1,(320,320))
t2,im2=read_img_as_tensor_gray(p2,(320,320))
# Inference
with torch.no_grad():
    #result=matcher(t1,t2)    #
    data={'image0':t1,'image1':t2}
    matcher(data)
    t0=time.time()
    times=1
    for i in range(times):
        matcher(data)
    rt1=time.time()-t0
    rt1=rt1/times
    mkpts0 = data['mkpts0_f']#.cpu().numpy()
    mkpts1 = data['mkpts1_f']#.cpu().numpy()
    print(data.keys())
    confidence = data['mconf']#.cpu().numpy()
    print(f'运行时间:{rt1:.4f}',mkpts0.shape,mkpts1.shape,confidence)

import cv2 as cv
pt_num = mkpts0.shape[0]
im_dst,im_res=im1,im2
img = np.zeros((max(im_dst.shape[0], im_res.shape[0]), im_dst.shape[1]+im_res.shape[1]+10,3))
img[:,:im_res.shape[0],]=im_dst
img[:,-im_res.shape[0]:]=im_res
img=img.astype(np.uint8)
match_threshold=0.01
for i in range(0, pt_num):
    if (confidence[i] > match_threshold):
        pt0 = mkpts0[i].to('cpu').numpy().astype(np.int32)
        pt1 = mkpts1[i].to('cpu').numpy().astype(np.int32)
        #cv.circle(img, (pt0[0], pt0[1]), 1, (0, 0, 255), 2)
        #cv.circle(img, (pt1[0], pt1[1]+650), (0, 0, 255), 2)
        cv.line(img, tuple(pt0.tolist()), (pt1[0]+im_res.shape[0], pt1[1]), (0, 255, 0), 1)
myimshow( img,size=12)

import cv2
def getGoodMatchPoint(mkpts0, mkpts1, confidence,  match_threshold:float=0.5):
    n = min(mkpts0.size(0), mkpts1.size(0))
    srcImage1_matchedKPs, srcImage2_matchedKPs=[],[]

    if (match_threshold > 1 or match_threshold < 0):
        print("match_threshold error!")

    for i in range(n):
        kp0 = mkpts0[i]
        kp1 = mkpts1[i]

        pt0=(kp0[0].item(),kp0[1].item());
        pt1=(kp1[0].item(),kp1[1].item());
        c = confidence[i].item();
        if (c > match_threshold):
            srcImage1_matchedKPs.append(pt0);
            srcImage2_matchedKPs.append(pt1);

    return np.array(srcImage1_matchedKPs),np.array(srcImage2_matchedKPs)
pts_src, pts_dst=getGoodMatchPoint(mkpts0, mkpts1, confidence)

h1, status = cv2.findHomography(pts_src, pts_dst, cv.RANSAC, 4)
# im_dst=im_dst.astype(np.float32)/255
# im_res=im_res.astype(np.float32)/255
print(im_dst.shape,im_dst.dtype,im_dst.max(),im_res.shape,im_res.dtype,im_res.max(),h1)
im_out1 = cv2.warpPerspective(im_dst, h1, (im_dst.shape[1],im_dst.shape[0]))
im_out2 = cv2.warpPerspective(im_res, h1, (im_dst.shape[1],im_dst.shape[0]),16)
#这里 im_res和im_out1是严格配准的状态
myimshowsCL([im_dst,im_out1,im_res,im_out2],rows=2,cols=2, size=6)
4.5 运行效果
代码运行输出信息如下,可以发现运行时间为79ms(运行环境为3060显卡,win10,台式机);将模型剥离时相关的configs\aspan\indoor\aspan_test.py中cfg.ASPAN.COARSE.TRAIN_RES 修改为[320,320],运行时间为0.0792。

提取出的点对关系如下,可以看到是比LoFTR要密集很多。LoFTR提取效果可以参看:https://hpg123.blog.csdn.net/article/details/140235431

提取出的重叠区域如下

海思 HiSpark 开发者社区是上海海思为开发者搭建的内容和交流平台,依托完备芯片解决方案、专业开发环境、开源/开放的软件资源与社区技术内容,构建完整服务生态开发者的闭环体系。
更多推荐
 23
 0
- 0


 已为社区贡献1条内容

所有评论(0)